

Modellkatalog
Der Assistenten-Editor zeigt einen kuratierten Katalog der für deinen Workspace verfügbaren Modelle:
Die Verfügbarkeit hängt von deinem Workspace und dem gewählten Engine-Modus ab.
Ist AI Safety & Control enthalten, kannst du Modelle für Pipeline-, Realtime- und Half-Cascade-Assistenten getrennt wählen. Andernfalls verwendet der Assistent die empfohlene automatische Auswahl.
Unter AI-Regionen & Modelle findest du eine Übersicht verfügbarer Modelle, EU-/US-Endpunkte, die automatische SIP-Umschaltung und die Infrastrukturstandorte.
Neue Sprachmodelle für Pipeline sind GPT-6 Sol, DeepSeek V4 Pro, Kimi K2.6, GPT-OSS 120B, Grok 4.3, Grok 4.5 und Grok 4.6. GPT-Live Transcribe und das ausschließlich englische Inworld STT 1 übernehmen die Spracherkennung in Pipeline. Gradium TTS Beta bietet Sprachausgabe auf Englisch, Französisch, Deutsch, Spanisch und Portugiesisch für Pipeline und Half-Cascade. Sichtbar sind nur aktivierte Modelle, die mit der Region deines Workspaces kompatibel sind. GPT-Live Transcribe ist von der Full-Duplex-Gesprächs-Engine getrennt. Manche Sprachmodelle verwenden feste Sampling-Einstellungen; der Temperaturregler hat bei ihnen keine Wirkung.
Wenn es für deinen Workspace aktiviert ist, nutzt Grok Voice 3.0 Realtime → Standard mit eigenen öffentlichen Stimmen, darunter Eve. Eine separate TTS-Stimme wird dabei nicht verwendet. Half-Cascade und Full Duplex werden für dieses Modell nicht unterstützt. Es gibt keinen dedizierten EU-Endpunkt; das Modell ist in EU-Workspaces nicht verfügbar.
Wähle im Stimmenkatalog Standard Realtime, um die passenden Stimmen zu finden. Über API und MCP kannst du sie mit
mode=realtime und realtime_variant=standard abrufen; gespeicherte Vorschauen nutzen den zurückgegebenen authentifizierten Vorschau-Link. Wenn du Modelle auswählen darfst, wähle beim Wechsel zu einer Stimme eines anderen Modells das passende Modell im selben Update. CLI: famulor list-voices --mode realtime --realtime-variant standard.
Grok Voice 3.0

Native Speech-to-Speech kann die Schritte zwischen Zuhören und Antworten reduzieren. Die tatsächliche Antwortzeit hängt vom Gespräch, der Verbindung und den Tool-Aufrufen ab; eine feste Ende-zu-Ende-Latenz ist nicht garantiert.
Primäres Spracherkennungsmodell
Mit AI Safety & Control öffnest du Assistenteneinstellungen → Allgemein → Erweitert. Im Modus Pipeline erscheint Spracherkennungsmodell (STT) unter dem Sprachmodell. Wähle einen verfügbaren Anbieter und ein Modell oder kehre zu Plattformstandard zurück. Die Liste berücksichtigt die KI-Region deines Workspaces. Bei Realtime, Full Duplex, Half-Cascade und Translate ist die Auswahl ausgeblendet und inaktiv. Ein Engine-Wechsel erhält deine Pipeline-Auswahl. Nur das primäre Erkennungsmodell ändert sich. Fallback-Modelle und ihre Reihenfolge verwaltet weiterhin die Plattform. Entfällt das Add-on oder ist ein gespeichertes Modell in der Workspace-Region nicht mehr verfügbar, verwenden nachfolgende Anrufe den zentralen Standard. REST: passende Modelle mitGET /api/v1/models?type=stt&mode=pipeline abrufen und den Assistenten über PUT /api/v1/assistants/{id} aktualisieren. MCP: get_models und update_assistant. Anbieter und Modell immer gemeinsam setzen; beide mit null auf den Standard zurücksetzen.
Temperature
Im Pipeline-Modus steuert Temperature, wie eng sich das Sprachmodell an deinen Prompt hält oder wie sehr es in der Formulierung variiert. Der Regler reicht von 0 – deterministisch und texttreu – bis zu kreativeren, improvisierten Antworten. Für Telefongespräche liegt ein typischer Bereich bei 0,5–0,8. Betrachte ihn als letzten Feinschliff, nicht als Ersatz für einen gut geschriebenen Prompt:- Schreib zuerst den Prompt fertig – Rolle, Ziele, Grenzen, Tonfall.
- Starte niedrig.
- Erhöhe den Wert in kleinen Schritten, erst wenn die Basis gut klingt.
- Teste und vergleiche nach jeder Änderung.
Stimmenbibliothek
Nutze den Stimmen-Picker, um nach Sprache und Stimmeigenschaften zu filtern, und höre dir vor dem Speichern ein Beispiel an. Die Bibliothek enthält Deepgram Aura-2, Rime Coda und Gradium TTS, mit Hörproben und Anbieterfiltern von A–Z. Gradium bietet 71 Flagship-Stimmen in fünf Sprachen. Die verfügbaren Stimmen richten sich nach der KI-Region und den ausgewählten Sprachen deines Workspaces.Gemini 3.8 für die Sprachausgabe
Gemini 3.8 Flash-Lite TTS und Gemini 3.8 Flash TTS sind Modelle zur Sprachausgabe für Pipeline- und Half-Cascade-Assistenten. Wähle eine vorgefertigte Gemini-Stimme und höre ihre Vorschau in der Stimmenbibliothek an. Flash-Lite TTS ist der Standard für Google-Stimmen; die gezielte Auswahl eines kompatiblen Modells benötigt AI Safety & Control. Beide unterstützen Dynamic emotions (Expressive Mode). Der Ausdruck kann sich an das Gespräch anpassen; die Wirkung einzelner Ausdrucksmittel hängt von Modell, Stimme und Text ab. Die Modelle sind in Global- und US-Workspaces über uneingeschränktes Global-Routing verfügbar. Die Einstellung US beschränkt die Verarbeitung dieser beiden Modelle nicht auf die USA. In EU-Workspaces sind sie nicht verfügbar. Sie ersetzen weder die Spracherkennung noch eine Realtime-Engine.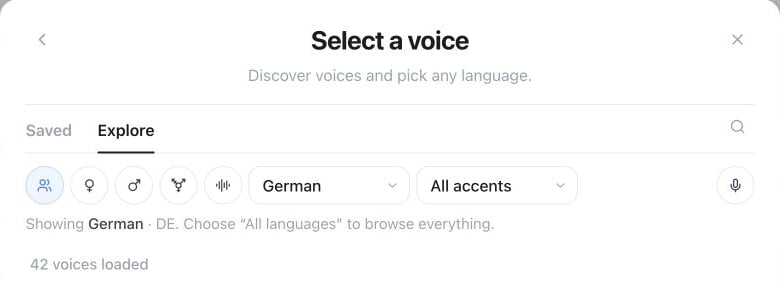
Assistenten-Editor → Change voice → Explore: Filtere die Bibliothek nach Sprache, Akzent und Stimmmerkmalen. Saved enthält deine gespeicherten Stimmen.
GET /api/v1/voices und das MCP-Tool get_voices liefern anbieterneutrale lokale Selektoren. Upstream-Stimmen-IDs und Lieferantennamen werden nicht offengelegt; übergib die zurückgegebene id direkt als tts_voice.
Dieselbe Stimmenliste erhältst du mit famulor list-voices --mode tts in der CLI oder client.voices.list({ mode: "tts" }) im TypeScript SDK. Verfügbare Modelle zur Sprachausgabe listest du mit GET /api/v1/models?type=tts&mode=pipeline, MCP get_models, famulor list-models --type tts --mode pipeline oder client.api.listModels({ query: { type: "tts", mode: "pipeline" } }). Dabei gelten dieselben Regeln für Workspace-Region und Modellzugriff.
- Assistant voice – die Standardstimme des Assistenten.
- Voice per flow agent – weise einzelnen Flow-Agenten unterschiedliche Stimmen zu.
- Voice per language – die Stimme wechselt zusammen mit der automatischen Sprachumschaltung.
- Cloned voices – wenn im Plan enthalten, füge eine private eigene Stimme hinzu und nutze sie wie eine Bibliotheksstimme.
sample_constraints über GET /api/v1/voices/clone/capability, um zu sehen, wie viele Samples aktuell akzeptiert werden (max_files, maximal 3), wie groß jedes Sample maximal sein darf (max_bytes_per_file) und wie lang jedes Sample maximal sein darf (max_duration_seconds, oder null bei keiner Längenbegrenzung), bereitest entsprechend viele direkte Uploads mit POST /api/v1/voices/clone/uploads vor, lädst die Samples hoch und sendest den Job anschließend mit POST /api/v1/voices/clone ab. MCP bietet dafür die gleichwertigen Tools get_voice_clone_capability, create_voice_clone_upload und submit_voice_clone. Dashboard, REST und MCP teilen dasselbe Entitlement Clone your own voice, dieselbe Einwilligungsprüfung, Erstellungspreise und Tenant-Isolation.
Sprechstil
Die verfügbaren Regler passen sich dem gewählten Modell an. Je nach Stimme stehen dir zur Verfügung:- Sprechgeschwindigkeit und Ausgabelautstärke;
- Stabilität, Ähnlichkeit oder Ausdrucksstärke;
- freie Stil-Anweisungen als Text;
- ein Aussprachewörterbuch für Namen, Abkürzungen und Fachbegriffe;
- Filter, die verhindern, dass Markdown und Emojis vorgelesen werden.
Glossar für die Spracherkennung
Öffne Assistant settings → Voice → Speech recognition, um Kunden-, Produkt- und Eigennamen zu hinterlegen, die zuverlässig transkribiert werden sollen. Das Glossar wirkt sich auf das Transkript aus; nutze zusätzlich das Aussprachewörterbuch, wenn ein Begriff auch eine besondere gesprochene Form braucht. Das Glossar wird nur angezeigt, wenn das tatsächlich verwendete Erkennungsmodell gespeicherte Begriffe in deinem Workspace unterstützt. Der Editor zeigt die Begriffs- und Zeichenlimits dieses Modells sowie gegebenenfalls einen Hinweis auf zusätzliche Nutzung an. Beim Modellwechsel bleiben gespeicherte Begriffe erhalten; nicht unterstützte Modelle verwenden sie jedoch nicht. Einige Modelle begrenzen zusätzlich die Gesamtgröße des Vokabulars. Dann werden nur die ersten passenden Begriffe verwendet; die vollständige gespeicherte Liste bleibt beim Modellwechsel erhalten. Gespeicherte Glossarbegriffe und automatische Erkennung haben unterschiedliche Anforderungen. Das Glossar kann verfügbar sein, auch wenn die automatische Erkennung nicht unterstützt wird. Das Hinzufügen gespeicherter Begriffe aktiviert die automatische Erkennung nicht. Ist Automatic term detection (Beta) verfügbar und aktiviert, kann der Assistent für den aktuellen Anruf zusätzliche Begriffe erkennen. Das kann zusätzliche KI-Nutzung verursachen. Erkannte Begriffe werden nicht in dein gespeichertes Glossar übernommen.Fallback-Ketten
Fallback chains ist ein einzelner Schalter, keine Auswahl, die du konfigurierst. Schalte ihn ein, und wenn der primäre Dienst für Spracherkennung, Sprachmodell oder Stimme mitten im Anruf ein Timeout, einen Fehler oder einen Abbruch erleidet, wechselt der Assistent automatisch zu einem kompatiblen Backup, damit das Gespräch weiterläuft, statt abzubrechen. Famulor wählt und pflegt, auf welches Backup jede Kette zurückfällt – es gibt keinen Picker für die Backup-Modelle selbst. Bei Pipeline-Sprachgesprächen und Text-Chats bleibt ein funktionierendes Ersatz-Sprachmodell ausgewählt, bis es ebenfalls ausfällt. So wird nicht wiederholt zu einem instabilen Hauptmodell zurückgewechselt. Neue Gespräche und Assistentenübergaben starten wieder mit dem gewählten Hauptmodell des jeweiligen Assistenten. Diese Regel ersetzt keine nativen Realtime-, Half-Cascade- oder Full-Duplex-Modelle und verändert keine Fallbacks für Spracherkennung oder Stimme.Fallback-Ketten sind Teil des Add-ons AI Safety & Control; die Verfügbarkeit prüfst du unter Settings → Plan. Ein Failover selbst verursacht keine zusätzlichen Kosten – ein Anruf, der ausweicht, wird weiterhin zum normalen Preis pro Anrufminute abgerechnet.
Teste wichtige Assistenten, nachdem du Modelle, Stimmen, Sprachen oder die Fallback-Reihenfolge geändert hast. Eine kurze Simulation reicht meist aus, um Unterschiede bei Aussprache und Timing zu erkennen.
Gespeicherte Ansagen
Bereite jede feste Ansage über kompakte Symbole direkt in ihrem Textfeld vor und höre sie dort an:- Begrüßung auf der Hauptseite des Assistenten: die Begrüßung und eine gegebenenfalls aktivierte statische Ansage nach Stille.
- Assistenteneinstellungen → Datenschutz → Einwilligung: die Einwilligungsansage.
- Im Editor des Auflegen-Tools: die Verabschiedung dieser Aktion.
GET /api/v1/assistants/{id}/announcements, POST auf demselben Pfad und den authentifizierten Audiolink fertiger Einträge. MCP und Milian unterstützen get_assistant_announcements und prepare_assistant_announcements. Audiovorschauen sind für den Workspace geschützt.
Stimmen erstellen und Credits
Stimmenklonen ist ein Plan-Feature. Öffne direkt Clone a voice: Der Button zeigt Erstellen · kostenlos, solange Freikontingent übrig ist, danach Erstellen + X Credits. Credits werden einmalig für eine erfolgreiche Erstellung berechnet. Gespeicherte Stimmen haben kein Planlimit und keine laufenden Speichergebühren. Sendeexpected_credits bei POST /api/v1/voices/clone oder submit_voice_clone mit dem angezeigten Wert pricing.next_creation_credits aus der Capability-Antwort. 0 akzeptiert nur eine kostenlose Erstellung. Steigt der Preis oder wird die letzte kostenlose Erstellung anderweitig verbraucht, lade den Preis neu und bestätige erneut. Verwende nach einem unterbrochenen Request dieselbe Job-ID; ein erfolgreicher Job wird nur einmal berechnet. Auch das ältere Tool clone_voice benötigt expected_credits.
Ersatzstimmen
Aktiviere unter Einstellungen → Gespräch → Fallbacks die Fallback-Ketten und wähle pro verfügbarer Stufe eine Stimme. Nutze dieselbe Stimmbibliothek mit Hörproben wie für die Hauptstimme. Die Grafik zeigt die Reihenfolge: Hauptstimme, danach bis zu drei Ersatzstimmen. Standard verwenden entfernt eine Auswahl. Speichere den Assistenten, um die Änderungen zu übernehmen. Erfordert Fallbacks & Guardrails. Die Plattform verwaltet Ersatzmodelle und deren Reihenfolge; die Bibliothek zeigt passende öffentliche Stimmen. Private geklonte Stimmen stehen hier nicht zur Verfügung. Pipeline und Half-Cascade nutzen diese Ersatzstimmen. Bei Full Duplex gelten sie nach dem Wechsel zur Pipeline-Sprachausgabe. Beim Ausschalten bleiben die Stimmen gespeichert, ohne Fallbacks zu aktivieren. REST:GET /api/v1/assistants/{id}/fallback-voices, PATCH /api/v1/assistants/{id}/fallback-voices, GET /api/v1/voices?fallback_position=1. MCP: get_assistant_fallback_voices, update_assistant_fallback_voices, get_voices (fallback_position).