

Dein Workspace-Plan kann Pipeline, Realtime, Half-Cascade und Translate unabhängig voneinander enthalten. Gesperrte Modi bleiben im Assistenten-Editor sichtbar und führen zur Plan-Seite. Diese Auswahl gilt beim Start eines Sprachanrufs oder Translate-Raums; reine Textnachrichten laufen weiterhin über den Text-Gesprächspfad des Assistenten.
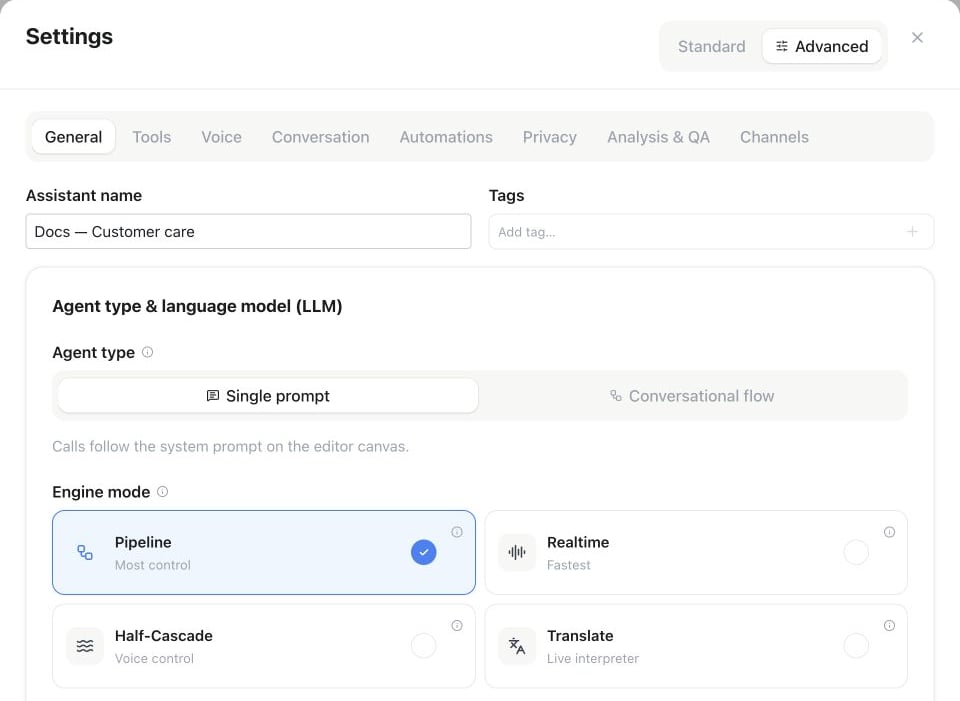
Assistenten-Settings → Advanced → General → Engine mode: Wähle Pipeline, Realtime, Half-Cascade oder Translate.
Pipeline (Standard)
Klassische dreistufige Architektur: Speech-to-Text → LLM → Text-to-Speech. Wähle jede Stufe aus den Modellen, die deinem Workspace zur Verfügung stehen.- Volle Kontrolle: Wähle STT, LLM und TTS unabhängig voneinander, inklusive Fallback-Ketten pro Stufe.
- Größte Modell- und Stimmenauswahl, beste mehrsprachige Abdeckung.
- Turn-Erkennung über ein semantisches Turn-Modell oder Sprachaktivitätserkennung (konfigurierbar).
Realtime
Ein einzelnes Speech-to-Speech-Modell hört zu und spricht direkt – ohne separates STT oder TTS.- Geringste Latenz und sehr natürliche Prosodie (Lachen, Zögern, Tonfall).
- Die Stimmenauswahl kommt aus dem Realtime-Modell.
- Die Turn-Erkennung kann robust, semantisch oder adaptiv arbeiten, wenn der gewählte Sprachmodus dies unterstützt. Andere Sprachmodi steuern das Timing automatisch.
- Weniger Stellschrauben: Stimmenbibliothek und Fallbacks pro Stufe entfallen.
Full Duplex (Beta)
Wähle unter Realtime zwischen Standard und Full Duplex (Beta), sofern die Option für deinen Workspace verfügbar ist. Full Duplex hört während des Sprechens weiter zu und steuert seine Sprecherwechsel selbst. Bestehende Assistenten bleiben auf Standard, bis du die Auswahl bewusst änderst. Regionale Verfügbarkeit: Full Duplex richtet sich nach den freigeschalteten Modellen der gewählten Workspace-Region, einschließlich EU, US und Global. Voraussetzung sind Beta-Zugriff, Realtime-Zugriff im Plan sowie passende Sprach- und Denkmodelle. Editor, API und MCP verwenden dieselben Verfügbarkeitsregeln. Wähle eine kompatible Gesprächsstimme. Full Duplex verwendet sie für Gespräche, Begrüßungen, Einwilligung und Tool-Ansagen. Normale Ansagen können umformuliert werden. Erforderliche Einwilligungsansagen werden mit dieser Stimme vorbereitet, geprüft und vollständig abgespielt, bevor eine Zustimmung akzeptiert wird; schlägt die Vorbereitung oder Wiedergabe fehl, endet der Anruf. Hochgeladene Begrüßungen behalten ihre aufgenommene Stimme. Die Ausweichstimme in den Einstellungen bleibt für Gespräche gespeichert, die auf Pipeline ausweichen müssen. Das Denkmodell wird zentral verwaltet. Sprecherwechsel-Erkennung und Antwortbereitschaft gelten für Full Duplex nicht. Teste Sprachen, Unterbrechungen und Tool-Abläufe vor Kundengesprächen. Bild- und Videoverständnis sind in dieser Variante nicht verfügbar. Das Geldsymbol zeigt die zusätzlichen Credits pro Minute. Full Duplex berechnet einen Aufpreis für die aktive Verbindungszeit einschließlich Pausen. Für AI Avatar gilt ein eigener Aufpreis, solange der Avatar aktiv ist; bei gemeinsamer Nutzung fallen beide an. Aktuelle Workspace-Preise stehen unter Usage, abgerechnete Anteile im Anrufverlauf. Die Preise werden beim Anrufstart festgehalten. Textfilter für Ausgaben und gesperrte Themen können native Sprache nicht filtern. Entferne diese Filter ausdrücklich, bevor du Full Duplex auswählst, oder behalte Standard. Schutz für Eingaben und Eskalationsregeln bleiben verfügbar. Eine Übergabe an einen Full-Duplex-Assistenten setzt einen Anruf voraus, der ursprünglich mit Full Duplex gestartet wurde. Beschreibe Rolle, gesprochene Sprache und Gesprächsstil in Full-Duplex-Prompts klar und knapp. Vermeide widersprüchliche Regeln zum Sprecherwechsel. Verwende die integrierte Einwilligungseinstellung für erforderliche Einwilligungsansagen oder lade eine Aufnahme für eine wortgetreue Begrüßung hoch; normale Begrüßungen und Tool-Ansagen können umformuliert werden. Eine gesprochene Unterbrechung bestätigt nicht, dass eine laufende Aufgabe abgebrochen wurde.Half-Cascade
Ein Hybrid: Ein Realtime-Modell übernimmt das Zuhören und Denken (rein textbasiert), während eine separate TTS-Stimme spricht. Half-Cascade hat eine eigene, textfähige Realtime-Modellauswahl, unabhängig von der vollständigen Realtime-Auswahl. Eine Änderung daran wirkt sich nie auf die separate TTS-Stimme aus.- Verständnis und Turn-Taking auf Realtime-Niveau, kombiniert mit der von dir gewählten TTS-Stimme – auch geklonte oder Markenstimmen sind möglich.
- Die Ausgabestimme konfigurierst du genau wie im Pipeline-Modus.
Translate
Ein Live-Dolmetscher für zwei Menschen. Der Gastgeber wählt beide Sprachen und Stimmen. Jeder Sprecher nimmt im Browser oder per Telefon teil und hört den anderen in seiner eigenen Sprache. Für die private Gasteinladung ist kein Konto erforderlich. Translate bewahrt Prompt-, Flow-, Tool-, Wissens- und Memory-Einstellungen für andere Modi auf, führt sie aber nicht aus. Die Anleitung Translate erklärt Räume, Einladungen, Telefonteilnahme, Stimmen und Verbrauch.Turn-Erkennung bei Realtime
Bei kompatiblen Realtime- und Half-Cascade-Assistenten legst du fest, wie der Assistent erkennt, dass der Anrufer zu Ende gesprochen hat:- Robust (VAD) – reagiert nach einer klaren Pause. Schnell und vorhersehbar.
- Semantic – wartet, bis der Anrufer seinen Gedanken offenbar zu Ende gebracht hat, auch bei einer Pause mitten im Satz. Response eagerness steuert, wie früh geantwortet wird.
- Adaptive – kurze Bestätigungen wie „mhm“ oder „okay“ stoppen den Assistenten nicht, während eine klare Unterbrechung den Anrufer übernehmen lässt. Zusätzlich lassen sich Mindeststille, Sprachempfindlichkeit und Unterbrechungsdauer einstellen oder Unterbrechungen ganz deaktivieren.
Zuverlässigkeitsverhalten
Ist die gewählte Realtime- oder Half-Cascade-Konfiguration vorübergehend nicht verfügbar, nutzt der Assistent nach Möglichkeit eine kompatible Ausweichoption, damit der laufende Anruf fortgesetzt werden kann.
Kurzvergleich
Fehlerbehebung
Kontextverlust mitten im Anruf
Der Assistent fragt nach Informationen, die er schon bekommen hat, oder scheint etwas Vorheriges vergessen zu haben. Das ist ein Verständnisproblem, kein Regler am Engine-Modus. Halte die benötigten Fakten in der Wissensdatenbank statt nur im Prompt, und nutze in einem Flowcollect-Knoten, damit erfasste Antworten zu Anrufvariablen werden, auf die der restliche Flow zugreifen kann, statt erneut zu fragen. Wenn dein Plan dir erlaubt, das Sprachmodell selbst zu wählen, hält ein leistungsfähigeres Modell auch ein langes Gespräch zuverlässiger zusammen.