

El plan de tu espacio de trabajo puede incluir Pipeline, Realtime, Half-Cascade y Translate de forma independiente. Los modos bloqueados siguen visibles en el editor del asistente y enlazan con la página Plan. Estos controles se aplican al iniciar una llamada de voz o una sala Translate; la mensajería de texto continúa por el recorrido de conversación de texto del asistente.
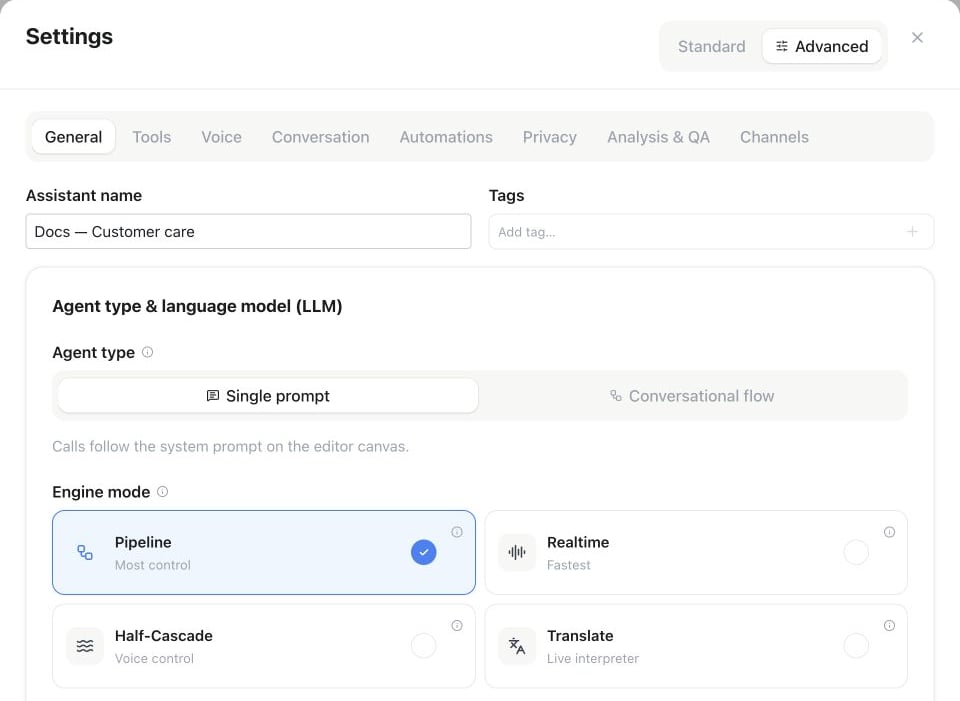
Settings del asistente → Advanced → General → Engine mode: selecciona Pipeline, Realtime, Half-Cascade o Translate.
Pipeline (predeterminado)
Arquitectura clásica de tres etapas: voz a texto → LLM → texto a voz. Elige cada etapa entre los modelos disponibles para tu espacio de trabajo.- Control total: elige el STT, el LLM y el TTS de forma independiente, incluidas las cadenas de respaldo por etapa.
- La selección de modelos y voces más amplia, con la mejor cobertura multilingüe.
- Detección de turno mediante un modelo de turno semántico o detección de actividad de voz (configurable).
Realtime
Un único modelo de voz a voz escucha y habla directamente — sin STT ni TTS por separado.- Latencia mínima y una prosodia muy natural (risas, dudas, tono).
- La voz se elige entre las que ofrece el propio modelo en tiempo real.
- La detección de turno puede ser robusta, semántica o adaptativa cuando el modo de voz seleccionado lo admite. El resto de modos de voz gestionan el ritmo de los turnos automáticamente.
- Menos opciones de ajuste: la biblioteca de voces y los respaldos por etapa no aplican.
Full Duplex (Beta)
En Realtime, elige Standard o Full Duplex (Beta) cuando esté disponible para tu espacio. Full Duplex sigue escuchando mientras habla y gestiona sus propios turnos de conversación. Los asistentes existentes conservan Standard hasta que cambies la selección de forma explícita. Disponibilidad regional: Full Duplex depende de los modelos habilitados para la región seleccionada del espacio, incluidas EU, US y Global. Requiere acceso beta, un plan con Realtime y modelos de voz y razonamiento compatibles. El editor, la API y MCP aplican las mismas reglas de disponibilidad. Elige una voz de conversación compatible. Full Duplex la usa para conversaciones, saludos, consentimiento y anuncios de herramientas. Los anuncios normales pueden reformularse. El consentimiento obligatorio se prepara con esa voz, se comprueba y se reproduce por completo antes de aceptarlo; si falla la preparación o reproducción, la llamada termina. Los saludos de audio subidos conservan su voz grabada. La Voz de respaldo se conserva para conversaciones que deban pasar a Pipeline. El modelo de razonamiento se gestiona de forma centralizada. Los controles de detección de turnos y disposición a responder no se aplican a Full Duplex. Prueba tus idiomas, interrupciones y herramientas antes de llamadas con clientes. Esta variante no admite comprensión de imágenes ni vídeo. El icono de dinero muestra los créditos adicionales por minuto. Full Duplex añade un suplemento por el tiempo de conexión activa, incluidas las pausas. AI Avatar tiene su propio suplemento mientras el avatar está activo; ambos se aplican cuando se usan juntos. Consulta las tarifas actuales del espacio en Usage y los importes cobrados en el historial de llamadas. Las tarifas se fijan al iniciar la llamada. Los filtros de texto de salida y los temas bloqueados no pueden filtrar la voz nativa. Desactiva esos filtros explícitamente antes de elegir Full Duplex o conserva Standard. La protección de entrada y las reglas de escalación siguen disponibles. Una transferencia a un asistente Full Duplex requiere que la llamada se haya iniciado originalmente con Full Duplex. En los prompts de Full Duplex, describe con claridad y brevedad el rol, el idioma hablado y el estilo de conversación. Evita reglas contradictorias sobre los turnos de habla. Usa el ajuste de consentimiento integrado para avisos obligatorios, o sube una grabación para un saludo que deba ser literal; los saludos normales y los anuncios de herramientas pueden reformularse. Una interrupción hablada no confirma que una tarea en curso se haya cancelado.Half-cascade
Un híbrido: un modelo en tiempo real se encarga de escuchar y pensar (solo texto), mientras que una voz TTS independiente se encarga de hablar. Half-cascade tiene su propia selección de modelo en tiempo real con capacidad de texto, independiente de la selección de Realtime completo. Cambiarla nunca modifica la voz TTS independiente.- Comprensión y manejo de turnos con calidad de tiempo real, combinados con la voz TTS que elijas, incluidas voces clonadas o de marca.
- La voz de salida se configura exactamente igual que en el modo Pipeline.
Translate
Un intérprete en directo para dos personas. El anfitrión elige ambos idiomas y voces y cada persona participa por navegador o teléfono. Cada una escucha a la otra en su propio idioma. La invitación privada no requiere una cuenta para el invitado. Translate conserva los ajustes de prompt, flujo, herramientas, conocimientos y memoria para otros modos, pero no los ejecuta. Consulta Translate para configurar salas, invitaciones, llamadas, voces y uso.Detección de turno en tiempo real
Para asistentes Realtime y Half-cascade compatibles, elige cómo decide el asistente que quien llama ha terminado de hablar:- Robust (VAD) — responde tras una pausa clara. Rápido y predecible.
- Semantic — espera hasta que quien llama parece haber terminado su idea, incluso con una pausa a mitad de frase. Response eagerness controla con cuánta rapidez responde.
- Adaptive — expresiones breves como «mhm» o «vale» no detienen al asistente, mientras que una interrupción clara deja que quien llama tome la palabra. También puedes ajustar el silencio mínimo, la sensibilidad de voz, la duración de interrupción, o desactivar las interrupciones.
Comportamiento de fiabilidad
Si la configuración de Realtime o Half-cascade elegida no está disponible temporalmente, el asistente usa una alternativa compatible cuando sea posible para que la llamada en curso pueda continuar.
Comparación rápida
Solución de problemas
Se pierde el contexto a mitad de llamada
El asistente pide información que ya se le dio, o parece haber pasado por alto algo dicho antes. Esto es un problema de comprensión, no un ajuste del modo de motor. Mantén los datos que necesita en la base de conocimientos en lugar de solo en el prompt, y en un flujo, usa nodoscollect para que las respuestas capturadas se conviertan en variables de llamada que el resto del flujo pueda usar en lugar de volver a preguntar. Si tu plan te permite elegir tú mismo el modelo de lenguaje, uno más potente también mantiene mejor el hilo de una conversación larga.