

Votre forfait peut inclure Pipeline, Realtime, Half-Cascade et Translate séparément. Les modes verrouillés restent visibles dans l’éditeur d’assistant et renvoient vers la page Forfait. Ces contrôles s’appliquent au démarrage d’un appel vocal ou d’un salon Translate ; la messagerie texte continue d’utiliser le parcours de conversation textuel de l’assistant.
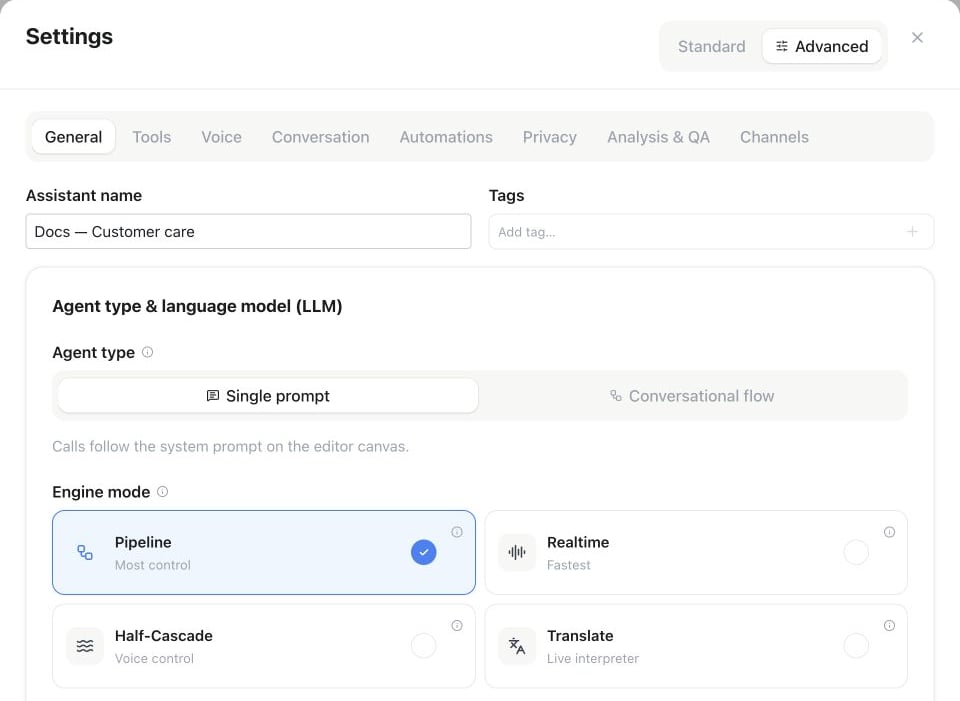
Settings de l’assistant → Advanced → General → Engine mode : choisissez Pipeline, Realtime, Half-Cascade ou Translate.
Pipeline (par défaut)
Architecture classique en trois étapes : reconnaissance vocale → LLM → synthèse vocale. Choisissez chaque étape parmi les modèles disponibles pour votre espace de travail.- Contrôle total : choisissez le STT, le LLM et le TTS indépendamment, avec des chaînes de secours pour chaque étape.
- Le plus large choix de modèles et de voix, la meilleure couverture multilingue.
- Détection de tour de parole via un modèle de détection sémantique ou une détection d’activité vocale (configurable).
Realtime
Un seul modèle voix-à-voix écoute et parle directement — sans STT ni TTS séparés.- Latence minimale et prosodie très naturelle (rires, hésitations, intonation).
- Le choix de la voix dépend du modèle Realtime utilisé.
- La détection de tour de parole peut être robuste, sémantique ou adaptative lorsque le mode vocal sélectionné le permet. Les autres modes vocaux gèrent le rythme des tours automatiquement.
- Moins de réglages disponibles : la bibliothèque de voix et les solutions de secours par étape ne s’appliquent pas.
Full Duplex (Beta)
Sous Realtime, choisissez Standard ou Full Duplex (Beta) lorsque cette option est disponible pour votre espace. Full Duplex continue à écouter pendant qu’il parle et gère ses propres tours de parole. Les assistants existants restent en Standard jusqu’à une modification explicite. Disponibilité régionale : Full Duplex dépend des modèles activés pour la région choisie de votre espace, y compris EU, US et Global. Il nécessite l’accès bêta, un forfait incluant Realtime et des modèles de parole et de raisonnement compatibles. L’éditeur, l’API et MCP appliquent les mêmes règles de disponibilité. Choisissez une voix de conversation compatible. Full Duplex l’utilise pour la conversation, les salutations, le consentement et les annonces des outils. Les annonces ordinaires peuvent être reformulées. Le consentement requis est préparé avec cette voix, vérifié et diffusé intégralement avant toute acceptation ; si la préparation ou la lecture échoue, l’appel se termine. Les salutations audio importées conservent leur voix enregistrée. La Voix de secours reste enregistrée pour une conversation qui doit passer en Pipeline. Le modèle de raisonnement est géré centralement. Les réglages de détection des tours et d’empressement de réponse ne s’appliquent pas à Full Duplex. Testez vos langues, interruptions et outils avant les appels clients. La compréhension d’images et de vidéos n’est pas disponible dans cette variante. L’icône monétaire affiche les crédits supplémentaires par minute. Full Duplex ajoute un supplément pour la durée de connexion active, pauses comprises. AI Avatar a son propre supplément lorsque l’avatar est actif ; les deux s’appliquent en cas d’utilisation simultanée. Consultez les tarifs de l’espace dans Usage et les montants facturés dans l’historique des appels. Les tarifs sont fixés au début de l’appel. Les filtres de texte en sortie et les sujets bloqués ne peuvent pas filtrer la parole native. Désactivez explicitement ces filtres avant de choisir Full Duplex, ou conservez Standard. La protection des entrées et les règles d’escalade restent disponibles. Un transfert vers un assistant Full Duplex exige un appel initialement démarré avec Full Duplex. Pour Full Duplex, décrivez clairement et brièvement le rôle, la langue parlée et le style de conversation. Évitez les règles contradictoires sur les tours de parole. Utilisez le réglage de consentement intégré pour les mentions requises, ou importez un enregistrement pour une salutation qui doit être exacte ; les salutations ordinaires et les annonces des outils peuvent être reformulées. Une interruption vocale ne confirme pas l’annulation d’une tâche en cours.Half-Cascade
Une architecture hybride : un modèle Realtime s’occupe de l’écoute et de la réflexion (en texte uniquement), tandis qu’une voix TTS distincte se charge de la parole. Half-Cascade dispose de sa propre sélection de modèle Realtime capable de texte, indépendante de la sélection Realtime complète. La modifier ne change jamais la voix TTS séparée.- Compréhension et gestion des tours de parole dignes du Realtime, combinées à la voix TTS de votre choix — y compris les voix clonées ou de marque.
- La voix de sortie se configure exactement comme en mode Pipeline.
Translate
Un interprète en direct pour deux personnes. L’hôte choisit les deux langues et voix, puis chaque personne participe sur le Web ou par téléphone. Chacune entend l’autre dans sa propre langue. L’invitation privée ne nécessite aucun compte pour l’invité. Translate conserve les paramètres de prompt, de flux, d’outils, de connaissances et de mémoire pour les autres modes sans les exécuter. Consultez Translate pour les salons, invitations, appels, voix et tarifs.Détection de tour de parole en Realtime
Pour les assistants Realtime et Half-Cascade compatibles, choisissez comment l’assistant détecte que l’appelant a fini de parler :- Robust (VAD) — répond après une pause nette. Rapide et prévisible.
- Semantic — attend que l’appelant semble avoir terminé son idée, même en cas de pause au milieu d’une phrase. Response eagerness détermine la rapidité de la réponse.
- Adaptive — les courtes marques d’écoute comme « mhm » ou « d’accord » n’arrêtent pas l’assistant, tandis qu’une véritable interruption laisse l’appelant reprendre la parole. Vous pouvez aussi régler le silence minimal, la sensibilité vocale, la durée d’interruption, ou désactiver les interruptions.
Comportement de fiabilité
Si la configuration Realtime ou Half-Cascade sélectionnée est temporairement indisponible, l’assistant utilise une solution de repli compatible si possible, afin que l’appel en cours puisse continuer.
Comparatif rapide
Dépannage
Perte de contexte en cours d’appel
L’assistant redemande une information déjà donnée, ou semble avoir manqué quelque chose dit plus tôt. C’est un problème de compréhension, pas un réglage lié au mode du moteur. Conservez les informations dont il a besoin dans la base de connaissances plutôt que dans le seul prompt, et dans un flux, utilisez des nœudscollect pour que les réponses capturées deviennent des variables d’appel que le reste du flux peut réutiliser au lieu de redemander. Si votre forfait vous permet de choisir vous-même le modèle de langage, un modèle plus performant tient aussi mieux une conversation longue dans la durée.